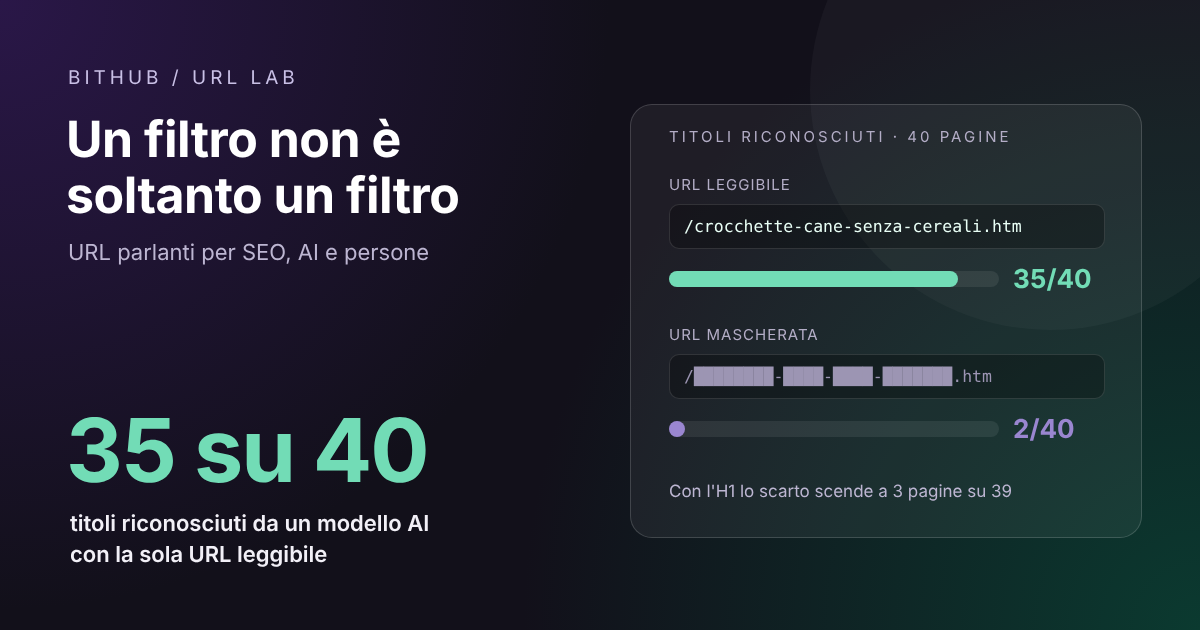
L'architettura di un eCommerce può trasformare una selezione di prodotti in una pagina tematica con un indirizzo comprensibile, un H1 e un testo dedicato. Un esperimento BitHub su 40 pagine misura il valore delle parole nell'URL per un modello AI. Il passo successivo è capire perché questo principio può essere utile anche per le categorie filtrate — e quali condizioni servono perché funzioni davvero.
Osservatorio BitHub · Studio sperimentale e approfondimento tecnico · 27 ottobre 2026
La differenza tra applicare un filtro e costruire una pagina
Un visitatore vuole acquistare crocchette senza cereali per un cane adulto. In molti negozi apre la categoria generale, seleziona alcuni filtri e arriva a un elenco di prodotti accompagnato da un indirizzo tecnico, magari con diversi parametri. L'operazione funziona: il catalogo si restringe. Ma l'indirizzo, preso isolatamente, può dire poco a chi lo riceve in una chat o a un software che analizza i collegamenti senza scaricare l'intera pagina.
L'impostazione descritta da BitHub è differente: prodotti, categorie e combinazioni di filtri possono essere rappresentati con URL vicine alla radice del dominio, parole leggibili e metadati editoriali specifici. Per ogni filtro o combinazione sono previsti un testo SEO dedicato, un H1 e un meta title coerenti con il risultato selezionato. La differenza sostanziale non è travestire un filtro da categoria, ma dare alla selezione un significato editoriale esplicito, riconoscibile da persone e sistemi automatici.
Consideriamo due esempi illustrativi, non URL di negozi reali: /crocchette-cane-senza-cereali.htm e /catalogo?categoria=12&tipo=7&grainfree=1. Possono portare allo stesso assortimento, ma il primo comunica immediatamente l'argomento; il secondo richiede una legenda dei parametri. Una URL descrittiva non garantisce indicizzazione né posizionamento. Può però contribuire a un sistema coerente di segnali semantici insieme a contenuto, link e dati strutturati. [1][2]
Vicino alla root: un vantaggio pratico, non un bonus di ranking automatico
Le URL BitHub tendono a mantenere prodotti e pagine tematiche vicini alla root, evitando molti livelli tecnici. È una scelta che può semplificare gli indirizzi, rendere più stabili gli slug quando cambia la tassonomia e facilitare la condivisione. Ma un solo segmento dopo il dominio non rende automaticamente una pagina più importante per Google. Le linee guida ufficiali raccomandano URL comprensibili e una struttura logica; la scoperta e la rilevanza delle pagine dipendono anche dai collegamenti interni e dai loro testi. [1][3]
È fondamentale distinguere profondità dell'URL e profondità di navigazione. La pagina /crocchette-cane-senza-cereali.htm può trovarsi a un livello dal dominio ed essere comunque praticamente invisibile se nessun link interno la raggiunge. Viceversa, /cane/alimentazione/crocchette/senza-cereali/ può essere una pagina autorevole e facilmente scopribile se compare in una buona struttura di navigazione. Un sito con URL piatte deve quindi comunicare la propria gerarchia attraverso categorie, anchor text, link contestuali e breadcrumb, non soltanto attraverso lo slug. Google consiglia persino che i dati strutturati BreadcrumbList rispecchino il percorso tipico dell'utente, senza obbligo di replicare le directory dell'URL. [3][4]
Il vantaggio distintivo: pagine per intenzioni di ricerca, non solo risultati filtrati
La possibilità di dedicare a ogni combinazione un H1, un title e un testo specifico apre una strada interessante: trasformare selezioni commercialmente significative in pagine di destinazione. Pensiamo a una categoria generale “crocchette per cani”, a una selezione “crocchette senza cereali” e a una più precisa “crocchette senza cereali per cani adulti”. Se ciascuna risponde a una necessità distinguibile, mostra un assortimento pertinente, spiega criteri e differenze e riceve collegamenti interni adeguati, il valore non consiste soltanto nell'aver cambiato URL.
La pagina può aiutare un utente a capire quali prodotti scegliere, perché sono inclusi, per chi sono indicati e come differiscono dalle alternative. Il testo dedicato dovrebbe rispondere a domande concrete, non limitarsi a sostituire alcune keyword in un modello ripetuto. Il title serve a descrivere il contenuto nei risultati di ricerca; l'H1 organizza e rende riconoscibile l'argomento visibile; la meta description, quando esiste ed è pertinente, può contribuire allo snippet ma non garantisce che Google la utilizzi. [5][6]
L'opportunità è particolarmente interessante per la long tail: combinazioni di marca, specie, esigenza, taglia, materiale, utilizzo o destinazione possono corrispondere a ricerche più circoscritte di quelle delle categorie madri. Naturalmente questa corrispondenza deve essere verificata con ricerche, impression, assortimento e comportamento degli utenti: non ogni combinazione tecnicamente possibile merita una landing page indicizzabile.
Cosa abbiamo misurato: il test BitHub su 40 URL
Per misurare il valore informativo di una URL, e non soltanto descriverlo, l'Osservatorio BitHub ha estratto un campione di 40 pagine (20 categorie e 20 prodotti) da 98 URL con title HTML valido, raccolte in 29 eCommerce. Il corpus di partenza conteneva 253 URL, di cui 124 interne. I domini sono stati sostituiti con il dominio neutro shop.example per evitare che il nome del negozio suggerisse la risposta.
Il modello qwen2.5:7b, eseguito localmente tramite Ollama senza accesso al Web, doveva identificare il title HTML corretto fra quattro alternative, potendo scegliere anche di astenersi. Per le stesse pagine sono state create URL leggibili, URL con le parole mascherate e prove senza URL; in altre due condizioni è stato fornito anche l'H1. Sono state elaborate 200 risposte. Il riferimento per la correzione era il title HTML registrato da Chrome, non una valutazione umana generale sulla qualità della pagina.
| Condizione sperimentale | Risposte corrette | Campione |
|---|---|---|
| Solo URL leggibile | 35 (87,5%) | 40 |
| Solo URL mascherata | 2 (5,0%) | 40 |
| Nessuna URL | 0 (0,0%) | 40 |
| URL leggibile e H1 | 34 (87,2%) | 39 con H1 disponibile |
| URL mascherata e H1 | 31 (79,5%) | 39 con H1 disponibile |
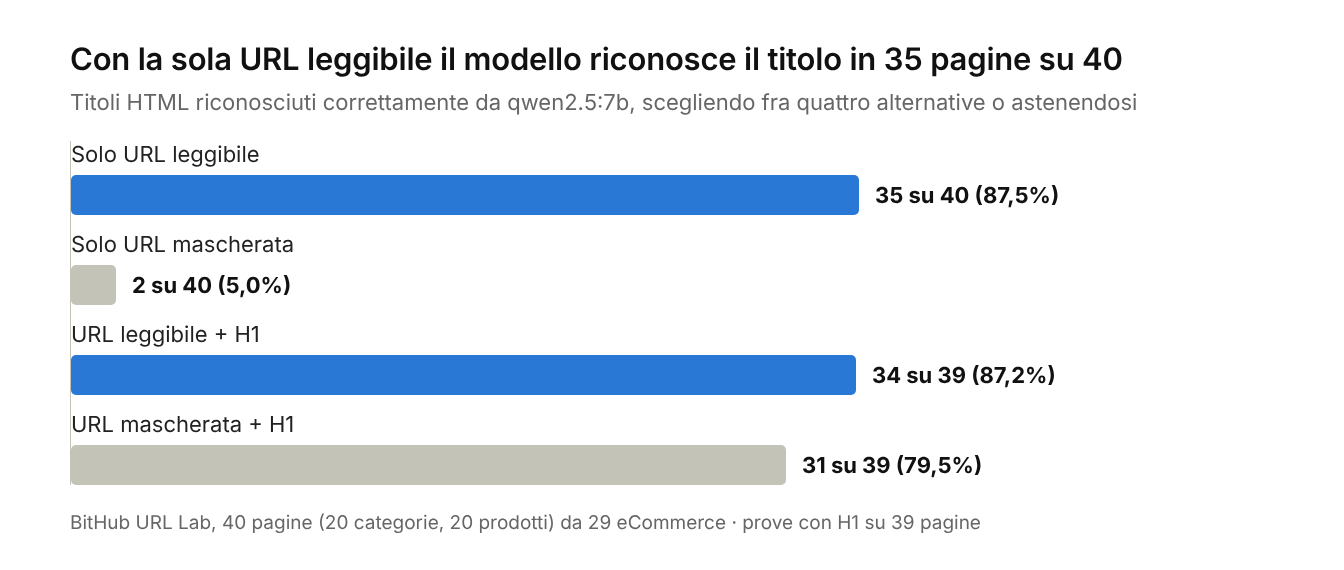
Con la sola URL leggibile il modello ha individuato correttamente il titolo in 35 casi su 40, contro 2 su 40 con parole mascherate. Nei 33 casi in cui il percorso leggibile ha corretto una risposta sbagliata o un'astensione del percorso mascherato, non si è verificato alcun passaggio opposto. È un risultato forte per questo compito sperimentale: l'indirizzo contiene informazioni che un modello può usare senza aprire la pagina.
La spiegazione non è tutta nell'AI. Un classificatore deterministico basato sulla sovrapposizione delle parole fra percorso e titoli aveva già riconosciuto 31 casi su 40 (77,5%). Non è dunque necessario attribuire a un modello sofisticato la capacità di utilizzare parole che sono già presenti in chiaro nell'indirizzo.
Quando è disponibile l'H1, la URL aggiunge meno
Le prove con H1 sono ancora più istruttive. Fra le 39 pagine con H1 effettivamente osservato, Qwen ha scelto il titolo corretto in 34 casi con URL leggibile e in 31 con URL mascherata: tre differenze favorevoli, nessuna contraria, cioè un vantaggio esplorativo di 7,7 punti percentuali. I tre casi migliorati erano pagine categoria; per le 19 schede prodotto con H1 tutte le risposte sono risultate corrette in entrambe le condizioni.
Questo ridimensiona la tesi più enfatica sulle URL: quando il sistema dispone già di un segnale testuale forte, il contributo marginale del percorso può essere modesto. Inoltre il prompt delle prove H1 conteneva un'istruzione introduttiva rimasta ambigua («Hai solo il percorso indicato») pur includendo l'H1. Il confronto con H1 va quindi replicato con una formulazione corretta prima di considerarlo una stima conclusiva.
La conclusione sperimentale sostenibile è precisa: una URL parlante funziona come un piccolo riassunto quando non si conosce ancora il contenuto; quando title, H1 e testo sono disponibili, conta la coerenza dell'insieme.
SEO e ricerca generativa: una base comune, non un trucco GEO
In una pagina BitHub ben progettata, un sistema automatico può trovare più livelli di descrizione allineati: slug, collegamenti interni, H1, title, testo tematico, selezione prodotti e, dove applicabile, dati strutturati. È un'architettura potenzialmente utile sia a un motore classico sia a un sistema che recupera documenti per generare una risposta. Ma non è corretto affermare che Google o gli assistenti AI “non si accorgano” della presenza di filtri. Possono riconoscere un elenco filtrato, confrontarne il contenuto con altre pagine e decidere se vale la pena conservarlo o citarlo.
Google dichiara che per comparire come fonte in AI Overviews e AI Mode non esiste una scorciatoia tecnica GEO: la pagina deve essere idonea nella Ricerca tradizionale, indicizzata e in grado di offrire contenuti accessibili e utili. La stessa documentazione richiama link interni, testi disponibili e dati strutturati corrispondenti alla pagina. Il vantaggio strategico di BitHub consiste quindi nel rendere recuperabile e comprensibile una risposta specifica a un bisogno specifico, non nel mascherare la tecnologia usata per produrla. [7]
Il nostro test non ha misurato rank, impression, click da Google, citazioni nei chatbot, crawling AI o tassi di conversione. Sarebbe fuorviante trasformare l'87,5% del laboratorio in un incremento SEO o GEO previsto. Il risultato fornisce piuttosto una ragione verificabile per progettare link leggibili e un'ipotesi da sottoporre a misurazione sul traffico reale.
Più leggibili per le persone: l'importanza del link fuori dalla SERP
Un URL è spesso una parte visibile della comunicazione: viene incollato in WhatsApp, in un'email, in una chat di assistenza, nel testo di un preventivo o in un forum. Un indirizzo come /shampoo_kerastase/ comunica un argomento; uno ricco di ID, parametri e codici temporanei può non farlo. Anche una pagina prodotto reale del nostro campione, /hill-s-prescription-diet-metabolic-12-kg-per-cane.htm, consente di anticipare marchio, linea, peso e destinazione d'uso prima del clic.
La leggibilità può facilitare l'orientamento, la fiducia informata, l'inserimento nei messaggi e la possibilità di verificare se un link sembra pertinente. È inoltre utile nei materiali editoriali, nelle guide, nei backlink e nell'assistenza clienti, dove il collegamento viene spesso letto o riportato manualmente. Non abbiamo misurato un aumento di CTR o conversioni dovuto alla brevità dell'URL, perciò questi restano benefici plausibili di usabilità, non percentuali attribuibili all'esperimento.
Una query string non è automaticamente un difetto: Google gestisce normalmente parametri correttamente strutturati, e in alcuni casi sono una scelta funzionale. Il problema nasce soprattutto da parametri ridondanti, identificatori di sessione e molte versioni dello stesso contenuto. L'obiettivo non è abolire il simbolo ?, ma disporre di un riferimento canonico stabile e leggibile per le pagine che hanno valore nel tempo. [1][2]
Altri benefici dell'architettura, oltre alla keyword nell'URL
Quando lo stesso contenuto è raggiungibile attraverso un percorso canonico coerente, è più facile proporlo in una sitemap, collegarlo dagli articoli, preservarlo dopo cambi di ordinamento e analizzarlo in Search Console senza disperdere i dati fra molte varianti. La semplicità può facilitare anche il debugging dei redirect, la gestione delle migrazioni e il riconoscimento delle pagine di maggior valore nei log, purché gli slug siano stabili e le modifiche abbiano una politica di redirect corretta. Google spiega che la canonicalizzazione serve proprio a scegliere versioni rappresentative e a consolidare alcuni segnali fra duplicati. [8]
Un'architettura del genere rende più semplice creare percorsi editoriali trasversali: da una guida su un'esigenza specifica si può collegare direttamente una selezione di prodotti già pertinente; da una pagina categoria si possono proporre combinazioni con reale domanda; il breadcrumb può preservare la gerarchia logica anche se gli URL sono piatti. Il contributo più prezioso non è la rimozione di caratteri dalla barra degli indirizzi, ma la capacità di associare stabilmente intenzione di ricerca, contenuto, assortimento e collegamenti.
Anche per le persone che amministrano il catalogo, separare le combinazioni strategiche dalle semplici preferenze temporanee rende più semplice governare title, descrizioni, aggiornamenti, prestazioni e qualità. La gestione editoriale esplicita non equivale però automaticamente a contenuto originale: scrivere testi molto simili per migliaia di combinazioni rischia di annullare il vantaggio.
Il rischio opposto: migliaia di landing quasi identiche
La navigazione a faccette è uno dei problemi più complessi del crawling eCommerce. Google documenta che combinazioni eccessive di filtri possono produrre spazi di URL praticamente illimitati, assorbendo risorse e rallentando la scoperta delle pagine utili. Aggiungere un URL leggibile, un title e un H1 a ogni variante non elimina il problema della duplicazione se l'assortimento e il contenuto principale restano quasi identici. Anche pagine create in massa per presidiare query minime possono ricadere in problemi di qualità o nelle norme contro doorway e contenuti su larga scala. [9][10] Abbiamo approfondito il tema nelle guide su quali filtri indicizzare e quali bloccare e sugli errori di canonical con varianti e filtri.
Il principio corretto è distinguere due insiemi. Il primo comprende filtri strategici, associati a intenzioni differenti, prodotti pertinenti, contenuto utile e domanda verificabile: sono candidati a URL canoniche stabili, link interni e — dopo controllo — indicizzazione. Il secondo comprende combinazioni di servizio (ordinamenti, opzioni occasionali, selezioni prive di prodotti, varianti ridondanti): devono essere gestite in modo da non moltiplicare inutilmente le pagine da scansionare. Non basta quindi disporre di un motore capace di generare testi per qualsiasi combinazione; serve una politica editoriale e tecnica per decidere quali meritano visibilità.
La documentazione Google raccomanda un ordine stabile dei filtri codificati nel percorso, l'assenza di attributi duplicati e uno status HTTP 404 per combinazioni inesistenti o prive di risultati. La canonical di una landing veramente distinta non andrebbe puntata automaticamente alla categoria madre, perché questo ne contraddirebbe l'obiettivo; per varianti sostanzialmente duplicate occorre invece una strategia di consolidamento coerente. Blocchi robots, noindex e canonical non sono equivalenti e devono essere scelti secondo lo scopo. [8][9]
Le condizioni perché la strategia BitHub produca un valore SEO misurabile
Per una pagina filtrata che si desidera rendere autonoma, il progetto ideale unisce slug permanente, un'unica URL canonica preferita, title e H1 coerenti, testo specifico di qualità, assortimento davvero pertinente, risposta HTML accessibile, collegamenti interni HTML <a href>, navigazione e breadcrumb sensati. Nei casi adatti, dati strutturati corretti e una sitemap selettiva possono completare il quadro. Nessuno di questi elementi, da solo, garantisce indicizzazione, né basta a dimostrare che la pagina sarà citata nelle risposte AI. [3][4][7]
Per misurare il beneficio reale, BitHub può confrontare un gruppo di landing filtrate strategiche con pagine comparabili non curate, verificando inizialmente che non ci siano differenze sostanziali di assortimento e linking. Le variabili osservabili dovrebbero includere indicizzazione e canonical scelto da Google, impression e click per query specifiche, visite dai motori, comportamento di scansione nei log, traffico alle pagine prodotto e conversioni. Per la ricerca AI servirebbe un protocollo di visibilità e citazioni ripetuto nel tempo, distinguendo rilevamento della pagina e successiva scelta come fonte. Sarebbe un terzo esperimento, diverso dal nostro test linguistico e più direttamente collegato al vantaggio commerciale dichiarato.
Se stai progettando o rifacendo il catalogo, è il lavoro che facciamo nello sviluppo eCommerce su misura e come SEO Specialist per eCommerce: decidere quali combinazioni meritano una pagina, scriverne i contenuti e misurarne i risultati. Un esempio di metodo e dati raccolti su un catalogo reale è il caso QuattrozampeShop.
Conclusione: non sono gli URL da soli a essere potenti, è ciò che rappresentano
Lo studio BitHub ha dimostrato che, quando il contenuto non è disponibile, un modello linguistico può riconoscere molto meglio la destinazione di una URL leggibile: 35 titoli corretti su 40, contro 2 quando si cancellano le parole del percorso. Con l'H1 già disponibile, il vantaggio osservato scende a tre casi su 39. È un risultato che invita a evitare sia lo scetticismo assoluto sia le promesse miracolose sulla GEO.
La prospettiva più interessante dell'architettura BitHub sta altrove: fare in modo che una combinazione di filtri utile possa diventare una pagina vera, con nome comprensibile, contenuto pertinente, metadati distintivi, prodotti selezionati e collegamenti interni. È una strategia che può aiutare i visitatori a orientarsi e creare basi migliori per la scoperta dei contenuti. Il vantaggio SEO o GEO effettivo dipenderà però da qualità, unicità, indicizzazione e risultati misurati, non dalla semplice vicinanza alla root o dal fatto che il motore non sia in grado di riconoscere un filtro.
Metodo e limiti
Campione intenzionale di 40 pagine (20 categorie, 20 schede prodotto) da 29 eCommerce, selezionate fra 98 URL con title HTML utilizzabile osservate il 26 ottobre 2026. Modello qwen2.5:7b eseguito localmente via Ollama, temperatura 0; quattro titoli candidati per prova, con facoltà di astensione. Totale 200 risposte nelle cinque condizioni; il confronto H1 esclude una pagina senza H1 osservato. Le URL mascherate erano sintetiche. I risultati misurano title-matching controllato, non ranking o citazioni AI; selezione dei candidati e formulazione del prompt possono influenzare l'esito. Il confronto marginale con H1 resta esplorativo; nelle 39 coppie con H1 i tre casi discordanti favoriscono tutti la URL leggibile, ma un test appaiato esatto bilaterale restituisce p = 0,25. La descrizione delle funzionalità delle landing filtrate BitHub deriva dall'architettura riferita dai responsabili e non costituisce un audit indipendente della loro indicizzazione.
Fonti
- Google Search Central — URL Structure Best Practices: developers.google.com/search/docs/crawling-indexing/url-structure
- Google Search Central — Designing a URL Structure for Ecommerce Sites: developers.google.com/search/docs/specialty/ecommerce/designing-a-url-structure-for-ecommerce-sites
- Google Search Central — Link Best Practices: developers.google.com/search/docs/crawling-indexing/links-crawlable
- Google Search Central — Breadcrumb structured data: developers.google.com/search/docs/appearance/structured-data/breadcrumb
- Google Search Central — Title links: developers.google.com/search/docs/appearance/title-link
- Google Search Central — Snippets and meta descriptions: developers.google.com/search/docs/appearance/snippet
- Google Search Central — AI features and your website: developers.google.com/search/docs/appearance/ai-features
- Google Search Central — Canonicalization: developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls
- Google Crawling Infrastructure — Managing faceted navigation: developers.google.com/crawling/docs/faceted-navigation
- Google Search Central — Spam policies, doorway and scaled content abuse: developers.google.com/search/docs/essentials/spam-policies
Casi, prompt ciechi, risposte del modello e tabella di verifica delle 40 pagine sono disponibili per la replica dello studio.
Domande frequenti su URL parlanti e filtri eCommerce
Una URL corta e vicina alla root posiziona meglio una pagina?
Non esiste un bonus di ranking documentato per la vicinanza alla root. Google raccomanda URL comprensibili e una struttura logica, ma la scoperta e l'importanza di una pagina dipendono soprattutto dai collegamenti interni, dai loro testi e dal contenuto.
Conviene creare una pagina indicizzabile per ogni combinazione di filtri?
No. Meritano una URL canonica stabile solo le combinazioni con un'intenzione di ricerca distinta, prodotti pertinenti, contenuto utile e domanda verificabile. Ordinamenti, varianti ridondanti e selezioni senza prodotti vanno gestiti per non moltiplicare le pagine da scansionare.
Le URL leggibili aiutano gli assistenti AI a capire una pagina?
Nel nostro test un modello eseguito in locale ha riconosciuto il titolo corretto in 35 pagine su 40 dalla sola URL leggibile, contro 2 su 40 con le parole mascherate. Quando era disponibile anche l'H1 il vantaggio è sceso a 3 casi su 39. Non abbiamo misurato citazioni reali nei chatbot.
Una URL con parametri è un problema per Google?
Non automaticamente: Google gestisce parametri strutturati correttamente. I problemi nascono da parametri ridondanti, identificatori di sessione e molte versioni dello stesso contenuto. Per le pagine che hanno valore nel tempo serve un riferimento canonico stabile e leggibile.