Copiare la descrizione di un prodotto dal sito di un produttore o dal catalogo di un fornitore è una pratica comune negli eCommerce. Sembra un'operazione semplice: si seleziona un testo, lo si incolla nella scheda prodotto e si passa all'articolo successivo. Ma insieme alle parole possono arrivare anche immagini che dipendono da altri siti, collegamenti non desiderati e grandi quantità di codice HTML che non appartengono affatto alla descrizione.
All'inizio potrebbe sembrare tutto a posto. A distanza di tempo, però, il fornitore cambia piattaforma, un'immagine non viene più caricata oppure una parte del contenuto appare con tag e simboli incomprensibili. In altri casi il problema rimane invisibile: la pagina sembra funzionare, ma contiene script, attributi inutili e dati tecnici importati per errore.
Quando gli stessi difetti si ripetono su migliaia di schede, il copia-incolla diventa un problema di qualità del catalogo, affidabilità, esperienza d'acquisto, SEO e sicurezza applicativa.
Il problema non è solo il testo copiato: è tutto quello che si porta dietro
Gli editor visuali utilizzati per inserire le schede prodotto spesso mantengono parte della formattazione presente nella pagina di origine. Quello che sembra un normale paragrafo può contenere decine di elementi superflui: contenitori annidati, stili, identificativi, attributi data-*, collegamenti a siti esterni e riferimenti a risorse che non appartengono al negozio.
A volte il copia-incolla trascina addirittura dati tecnici usati dal sito del fornitore: identificativi dei prodotti, prezzi, disponibilità, varianti, percorsi delle immagini e interi oggetti JSON. Sono informazioni tecniche che servivano alla piattaforma originale, non al cliente che legge la descrizione.
Il risultato è una scheda inutilmente complessa. Alcuni elementi sono semplicemente ridondanti. Altri possono compromettere la leggibilità o provocare comportamenti non previsti. Più a lungo rimangono nel catalogo, più diventano difficili da riconoscere e correggere manualmente.
Quando l'HTML compare come testo o i tag sono incompleti
Può capitare che una descrizione contenga HTML codificato: invece di un normale paragrafo, nella pagina compaiono sequenze come <p>, <div> o altre entità che avrebbero dovuto essere interpretate come struttura del documento.
Esistono anche casi di codice copiato a metà: tag aperti e mai chiusi, attributi spezzati, porzioni di un oggetto JSON rimaste fuori dal loro contenitore. Il browser prova a interpretare il contenuto, ma non sempre il risultato corrisponde a quello voluto. In certe schede, tra le istruzioni d'uso e la descrizione del prodotto, possono comparire stringhe tecniche lunghe migliaia di caratteri.
Eliminare soltanto i link esterni non risolve situazioni del genere. Serve distinguere le informazioni utili per l'acquirente dal codice importato per errore, ricostruendo poi un HTML semplice e coerente.
Link esterni, destinazioni obsolete e clienti mandati altrove
Una descrizione copiata può includere collegamenti al catalogo originale, a una scheda tecnica non più disponibile, a una vecchia promozione o perfino a un altro eCommerce. Se la destinazione scompare, il cliente trova un errore. Se cambia contenuto o proprietario, il collegamento può portarlo a una pagina diversa da quella prevista.
Per un negozio online c'è anche un rischio commerciale: un link inserito senza controllo può far uscire il visitatore dalla scheda proprio mentre sta valutando l'acquisto, magari indirizzandolo a un concorrente.
Questo non significa che tutti i link esterni siano dannosi. Un riferimento a documentazione ufficiale, a istruzioni del produttore o a una fonte autorevole può essere utile. Il problema sono i collegamenti non pertinenti, rotti, non verificati o importati senza intenzione. Se una scheda è piena di collegamenti che restituiscono errori, l'utente fatica a verificare informazioni e documenti: l'esperienza peggiora, la pagina appare meno curata e diventa meno utile. È un problema SEO concreto, anche se Google non assegna una penalizzazione automatica per ogni singolo link esterno non funzionante. Quando i collegamenti rotti sono interni, inoltre, possono impedire agli utenti e ai crawler di raggiungere le pagine che avrebbero dovuto trovare. Indicazioni di Google sui collegamenti.
Immagini esterne: un prodotto può perdere le sue fotografie senza alcuna modifica al negozio
Le immagini possono essere visualizzate sul proprio eCommerce pur essendo ospitate su server di terze parti. In pratica, quando il cliente apre la pagina, il browser deve raggiungere anche il server da cui proviene la fotografia.
Il fornitore potrebbe riorganizzare i file, cambiare URL, impedire l'hotlinking o rendere il proprio server temporaneamente indisponibile. La scheda allora mostra un'immagine rotta, uno spazio vuoto o una fotografia che si carica solo a intermittenza. Un problema apparentemente piccolo può compromettere la comprensione di formati, confezioni, varianti e istruzioni.
Le immagini rotte incidono direttamente sulla qualità della scheda prodotto: il cliente non vede la confezione o i dettagli che cercava, mentre Google può non riuscire a scoprire o indicizzare quella risorsa per Google Immagini e per le funzionalità di ricerca che mostrano fotografie. Se il caricamento o la gestione delle immagini peggiora le metriche reali come LCP e stabilità visiva, può incidere anche sull'esperienza di pagina considerata dai sistemi di ranking. Il danno non è identico per tutte le pagine, ma su un catalogo con centinaia di immagini non funzionanti non è ragionevole considerarlo una semplice imperfezione estetica. Guida di Google alle immagini.
Le risorse esterne aggiungono inoltre dipendenze che il gestore del negozio non controlla. Non è vero che ogni immagine esterna sia lenta: una CDN ben configurata può funzionare ottimamente. Ma affidarsi senza verifiche al server di un altro sito rende più complicato garantire continuità e prestazioni.
Per ridurre questi rischi si possono trasferire, quando consentito, le immagini utili su un'infrastruttura gestita dal negozio, correggendo i relativi riferimenti. Le immagini non più disponibili vanno individuate e, se importanti, sostituite con risorse appropriate, anziché lasciare elementi rotti in pagina.
Copiare HTML senza controllarlo può creare anche problemi di sicurezza
C'è una differenza sostanziale tra copiare un testo e importare codice eseguibile o contenuti incorporati. Un attributo data-* non è, da solo, una vulnerabilità. Nemmeno un normale link verso l'esterno rappresenta automaticamente un pericolo.
Il rischio cresce quando il contenuto copiato contiene script, gestori di eventi come onclick o onerror, iframe e altre istruzioni che il browser potrebbe interpretare. Se un'applicazione pubblica HTML non affidabile senza adeguata sanificazione, possono crearsi le condizioni per problemi di sicurezza, comprese vulnerabilità di tipo cross-site scripting (XSS). Guida OWASP alla sanificazione HTML.
Anche le immagini e le altre risorse caricate da domini terzi possono generare richieste verso server non controllati dal negozio. Il gestore di quei server può ricevere informazioni tecniche sulla connessione, come l'indirizzo IP e, a seconda delle impostazioni, alcuni dati di provenienza. Risorse non HTTPS possono inoltre provocare anomalie di mixed content o essere bloccate dal browser.
È importante non confondere i segnali con le prove: trovare uno script o un attributo sospetto in una descrizione non significa aver scoperto un attacco o dimostrato una vulnerabilità sfruttabile. Significa aver individuato materiale non necessario che merita una verifica e, quando opportuno, una rimozione. La bonifica dell'HTML è una buona pratica, non un sostituto delle verifiche di sicurezza applicativa.
Link rotti e immagini mancanti possono danneggiare il posizionamento su Google?
Sì: sono problemi SEO da correggere, soprattutto quando si ripetono su molte pagine. Una scheda prodotto con fotografie mancanti, riferimenti che non funzionano e testo tecnico incomprensibile offre un'esperienza peggiore e può risultare meno utile rispetto a pagine concorrenti più complete e affidabili. Non è soltanto un problema di immagine aziendale: la qualità e il funzionamento delle pagine possono influire sulle prestazioni organiche.
È però necessario distinguere i meccanismi. Un link esterno che restituisce 404 non provoca automaticamente una penalizzazione di ranking: Google non pubblica un fattore di ranking del tipo «ogni link esterno rotto fa perdere posizioni». I collegamenti interni rotti possono invece interrompere percorsi di navigazione e scoperta dei contenuti. Se l'errore è diffuso, riduce la fruibilità complessiva del catalogo.
Le immagini non disponibili hanno conseguenze SEO ancora più evidenti. Se il file non viene caricato, quella fotografia non può essere utilizzata normalmente nelle esperienze di ricerca visiva. Google indica espressamente che l'individuazione, l'accessibilità e la corretta integrazione delle immagini contano per la loro indicizzazione. Inoltre immagini mal gestite o lente possono contribuire al peggioramento di Core Web Vitals, metriche impiegate nei sistemi di ranking, in particolare quando l'immagine riguarda un elemento principale della pagina. Core Web Vitals nella documentazione Google.
A questo si aggiunge la qualità del contenuto: una descrizione che mostra frammenti JSON, codici HTML e riferimenti al negozio del fornitore comunica poca cura e può compromettere la comprensione delle informazioni utili. L'HTML superfluo, preso da solo, non causa una penalizzazione. Diventa un problema quando ostacola visualizzazione, accessibilità, velocità o chiarezza.
Esiste poi un problema distinto: descrizioni identiche a quelle di tanti altri negozi offrono spesso poco valore aggiunto. Non scatta una penalizzazione automatica per ogni testo duplicato, ma è più difficile distinguersi se non si aggiungono informazioni utili, chiarimenti e dettagli specifici per l'acquirente.
Correggere questi errori elimina ostacoli reali alla SEO, pur senza poter promettere un aumento misurabile delle posizioni per ogni singola pagina: l'effetto dipende dal tipo di difetto, dalla sua diffusione e dalla concorrenza.
Un caso concreto: quante anomalie possono nascondersi in un catalogo?
Durante una recente attività di controllo e bonifica di un catalogo eCommerce, abbiamo esaminato 11.797 pagine. Il riepilogo dell'elaborazione ha individuato 6.752 pagine interessate da modifiche, oltre la metà delle pagine analizzate. Non erano migliaia di descrizioni scritte male: in molti casi erano testi commerciali leggibili, circondati però da codice importato e mai ripulito.
L'analisi ha segnalato 4.085 pagine contenenti HTML codificato, oltre 11.800 attributi data-* e più di 105.000 contenitori HTML superflui. Sono stati inoltre rilevati e rimossi 390 elementi classificati come script o tag potenzialmente pericolosi. Quest'ultimo numero indica elementi di markup eliminati, non attacchi informatici accertati.
Le cifre riguardano uno specifico intervento, non rappresentano una media del settore e non dimostrano da sole un miglioramento di posizionamento su Google. Mostrano però un fatto concreto: in un catalogo ampio, piccoli errori ripetuti diventano rapidamente migliaia di anomalie. È per questo che il controllo manuale di qualche scheda campione non basta.
Come interviene BitHub per correggere il problema
In BitHub affrontiamo la bonifica delle descrizioni come un'attività di qualità del catalogo. Prima identifichiamo i contenuti anomali e distinguiamo ciò che deve rimanere da ciò che appartiene alla struttura tecnica del sito d'origine. Non trattiamo allo stesso modo un paragrafo utile, un'immagine del prodotto, un riferimento a una fonte autorevole e un blocco di dati di una piattaforma esterna.
Quando un collegamento non serve, ne rimuoviamo la destinazione conservando, dove possibile, le parole che aiutano il cliente. Verifichiamo le immagini ospitate altrove e ne gestiamo la disponibilità, recuperandole o sostituendole quando appropriato e consentito. Ripuliamo gli elementi HTML indesiderati, i dati tecnici estranei, gli attributi inutili e le strutture malformate, cercando di preservare la leggibilità e l'organizzazione delle informazioni.
Alcuni interventi sono automatizzabili. Altri richiedono controlli specifici, soprattutto quando il contenuto di origine è incompleto o molto danneggiato. Le descrizioni possono contenere anche dosaggi, avvertenze e indicazioni d'uso che non devono essere trattati come semplice rumore. Per questo un processo serio prevede analisi preventiva, verifiche sul risultato e attenzione ai casi dubbi.
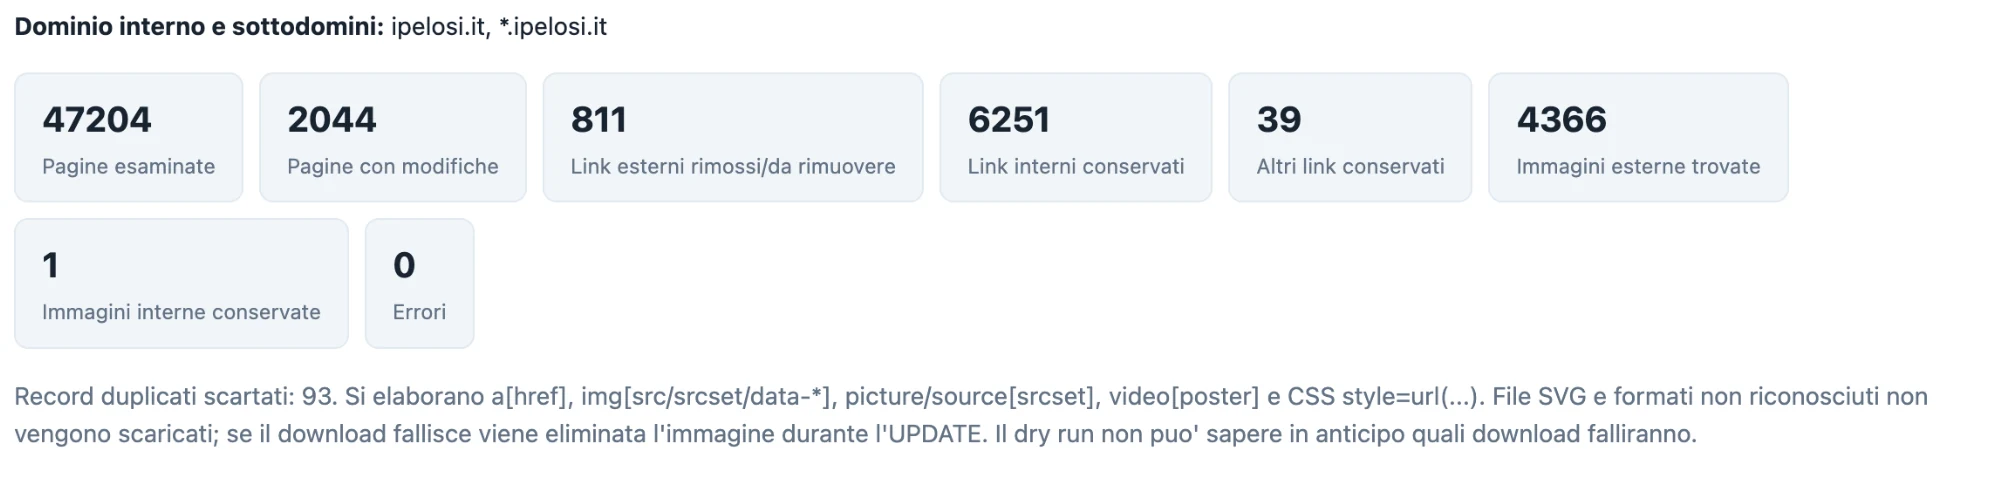
Il vantaggio è concreto: ridurre i problemi che ostacolano la SEO, recuperare immagini accessibili ai clienti e ai motori di ricerca, eliminare percorsi non funzionanti e offrire schede più chiare e affidabili. Non promettiamo un salto automatico nelle SERP: misuriamo la qualità tecnica dell'intervento e, quando disponibili, monitoriamo nel tempo indicizzazione, impressioni, traffico organico e conversioni.
È un lavoro che si collega naturalmente alla nostra attività di SEO tecnica per eCommerce e alle verifiche di sicurezza dei siti e delle applicazioni web.
Prevenire è meglio che correggere migliaia di schede
La prima difesa è controllare ciò che si importa. Chi inserisce un nuovo prodotto dovrebbe verificare non soltanto come appare la descrizione, ma anche dove puntano i collegamenti, dove sono ospitate le immagini e se l'editor ha trascinato codice non necessario. Un sistema di pubblicazione ben configurato può filtrare il markup indesiderato prima che finisca online.
Conviene poi arricchire i contenuti con informazioni davvero utili: caratteristiche, compatibilità, istruzioni, differenze fra varianti e risposte alle domande frequenti dei clienti. In questo modo una descrizione non è soltanto una copia del catalogo del produttore, ma diventa una pagina che aiuta a scegliere.
Infine serve un controllo periodico. I fornitori cambiano piattaforma, i collegamenti smettono di funzionare e anche i contenuti pubblicati da anni possono accumulare problemi. Un catalogo non rimane affidabile semplicemente perché nessuno lo modifica.
Domande frequenti
I link rotti e le immagini mancanti possono far perdere posizioni su Google?
Sì, possono contribuire a un peggioramento delle prestazioni SEO, in particolare se il problema riguarda molte schede. Le immagini irraggiungibili perdono opportunità di visibilità nelle ricerche visive. Le risorse mal gestite possono peggiorare caricamento ed esperienza. I link rotti rendono meno utili le pagine e, se interni, possono ostacolare la navigazione e la scoperta di contenuti. Non esiste però una penalizzazione automatica per ogni singolo collegamento esterno rotto.
Bisogna eliminare tutti i link esterni per migliorare la SEO?
No. I collegamenti pertinenti possono essere utili. Bisogna correggere quelli rotti, fuorvianti, non controllati o importati per errore, non eliminare indiscriminatamente i riferimenti validi.
Gli attributi `data-*` e i tag HTML superflui sono pericolosi?
Non necessariamente. Molti sono innocui o servono al funzionamento di componenti web. Ma se vengono copiati in una descrizione da un sito diverso, spesso non hanno più utilità. La presenza di script o di elementi eseguibili richiede inoltre un controllo di sicurezza più attento.
Perché in una scheda prodotto compaiono tag HTML o lunghi blocchi di testo incomprensibili?
Di solito perché l'HTML è stato codificato, copiato o salvato in modo errato, oppure perché insieme al testo sono stati importati dati tecnici della piattaforma originale. Occorre separare il testo destinato al cliente dal materiale non pertinente e ricostruire una formattazione corretta.
Perché le immagini scompaiono anche se non abbiamo cambiato nulla sul sito?
Spesso perché il file viene caricato da un server esterno. Se quel server cambia URL, rimuove l'immagine o blocca l'accesso diretto, la fotografia smette di comparire. Per le risorse importanti è preferibile disporre di file controllati dal negozio, nel rispetto dei relativi diritti d'uso.
La pulizia HTML sostituisce una verifica di sicurezza del sito?
No. Rimuovere codice indesiderato dalle descrizioni riduce alcuni rischi, ma non verifica l'intera applicazione, i suoi componenti, i controlli di accesso o le possibili vulnerabilità. La sicurezza richiede controlli dedicati.
Bisogna riscrivere tutte le descrizioni prodotto?
Non sempre. È possibile correggere molti difetti tecnici senza riscrivere ogni scheda. La revisione editoriale va poi concentrata sui contenuti più importanti, carenti o poco utili rispetto alle esigenze degli acquirenti.
Un catalogo affidabile non si ferma al copia-incolla
Una descrizione prodotto non è soltanto testo: è parte dell'esperienza di acquisto, della qualità complessiva del sito e del rapporto di fiducia con il cliente. Collegamenti dimenticati, immagini che dipendono da terzi e codice importato senza controllo sono problemi che possono restare nascosti per anni.
BitHub aiuta gli eCommerce a individuare e correggere su larga scala link non funzionanti, immagini mancanti e codice HTML importato per errore. Non si tratta di una semplice pulizia estetica: sono interventi che possono rimuovere ostacoli alla visibilità organica e migliorare l'esperienza di acquisto, con effetti da verificare attraverso dati di ricerca e prestazioni reali.